先週のHadoop Summitに続き、今週はSpark Summitが開催されています。盛りだくさんですね。
http://2015.hadoopsummit.org/
https://spark-summit.org/2015/
日本でも、来週は23日にSpark Casual Talk #1、25日に HBase Meetup Tokyo Summer 2015が開催されます。(共に定員オーバー。大人気)
- Spark Casual TalkのLTでは、Hueについて話す時間をいただきました。今週のSpark SummitでHueのNotebookの注目度がかなり高かったと聞いてますので、その辺の話を。
- HBase Meetupでは司会をやることになりそう…
- さらに、26日のインテル HPC+ FORUMでビッグデータ基盤とHadoopについて
- 7/9はHadoop活用の落とし穴
でお話しさせていただく予定です。興味があれば是非ご参加下さい。
Spark 1.4.0
さて、そんな中Spark 1.4.0がリリースされました。
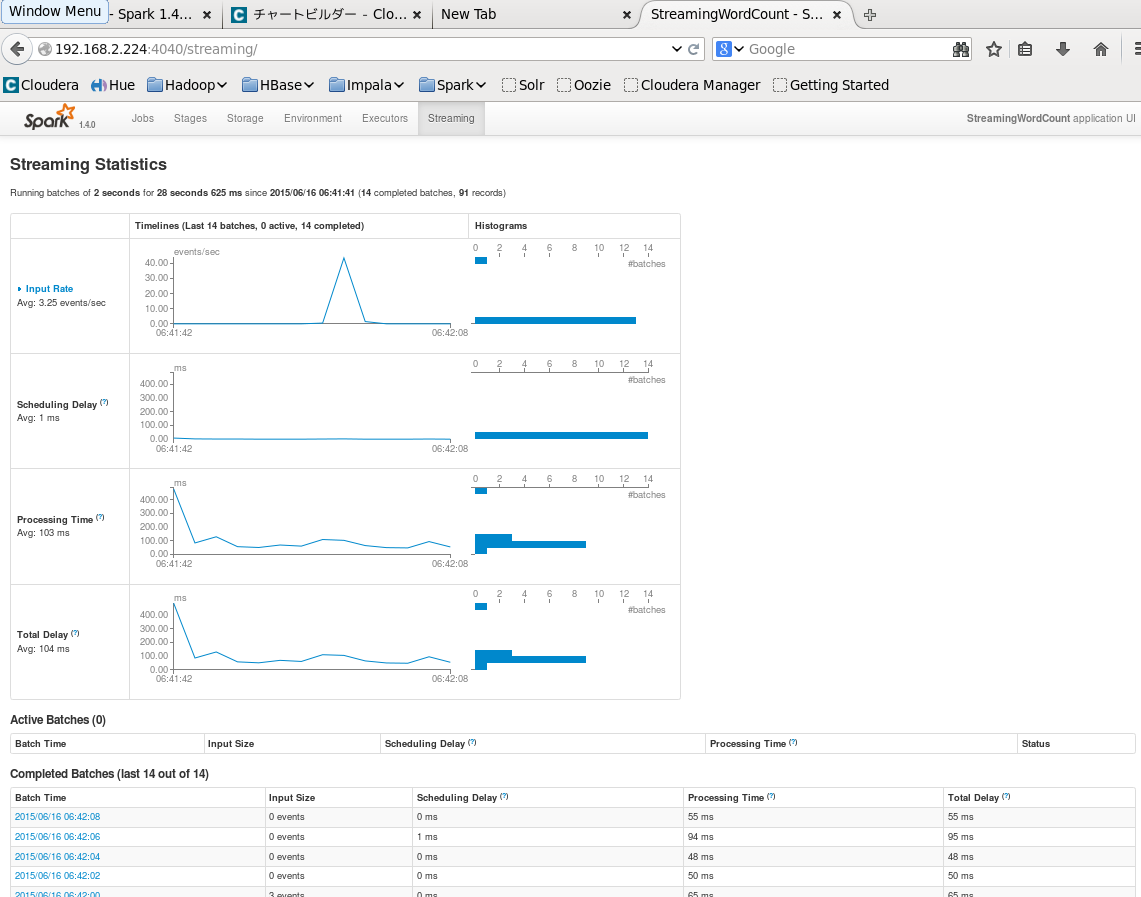
SparkRのサポートなども興味深いですが、見た目でインパクトがあった DAG ViewerとSpark Streamingの統計情報のスクリーンショットを撮ったので貼っておきます。
DAG Viewer
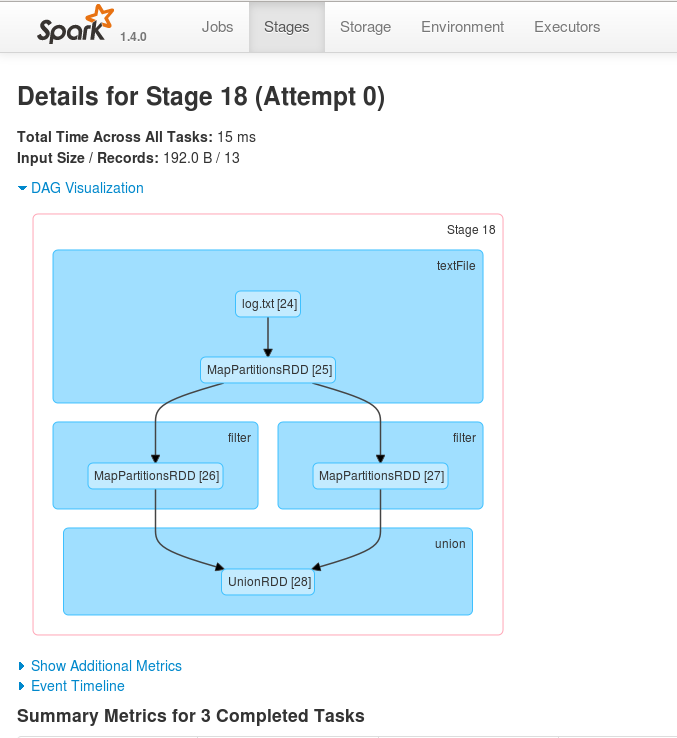 今まではこのように確認していたので、視覚的にかなりわかりやすいですね
[code]
scala> badLinesRDD.toDebugString
res6: String =
(4) UnionRDD[9] at union at <console>:27 []
| MapPartitionsRDD[7] at filter at <console>:23 []
| MapPartitionsRDD[6] at textFile at <console>:21 []
| log.txt HadoopRDD[5] at textFile at <console>:21 []
| MapPartitionsRDD[8] at filter at <console>:23 []
| MapPartitionsRDD[6] at textFile at <console>:21 []
| log.txt HadoopRDD[5] at textFile at <console>:21 []
[/code]
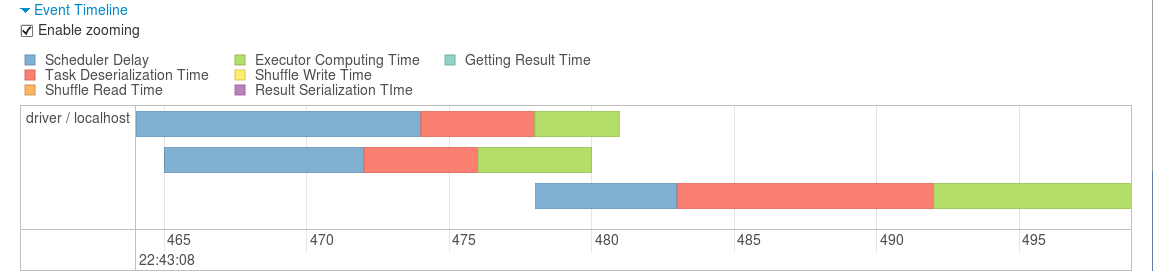
Event timeline
Spark Streaming statistics

コメント